Gemini 4 Carbon: первое место по бенчмаркам
Google выпустила Gemini 4 Carbon: 59 баллов и первое место в рейтинге Artificial Analysis. Доступ пока только участникам программы Fairwind.
Технологии / ИИ · Новости
Все новости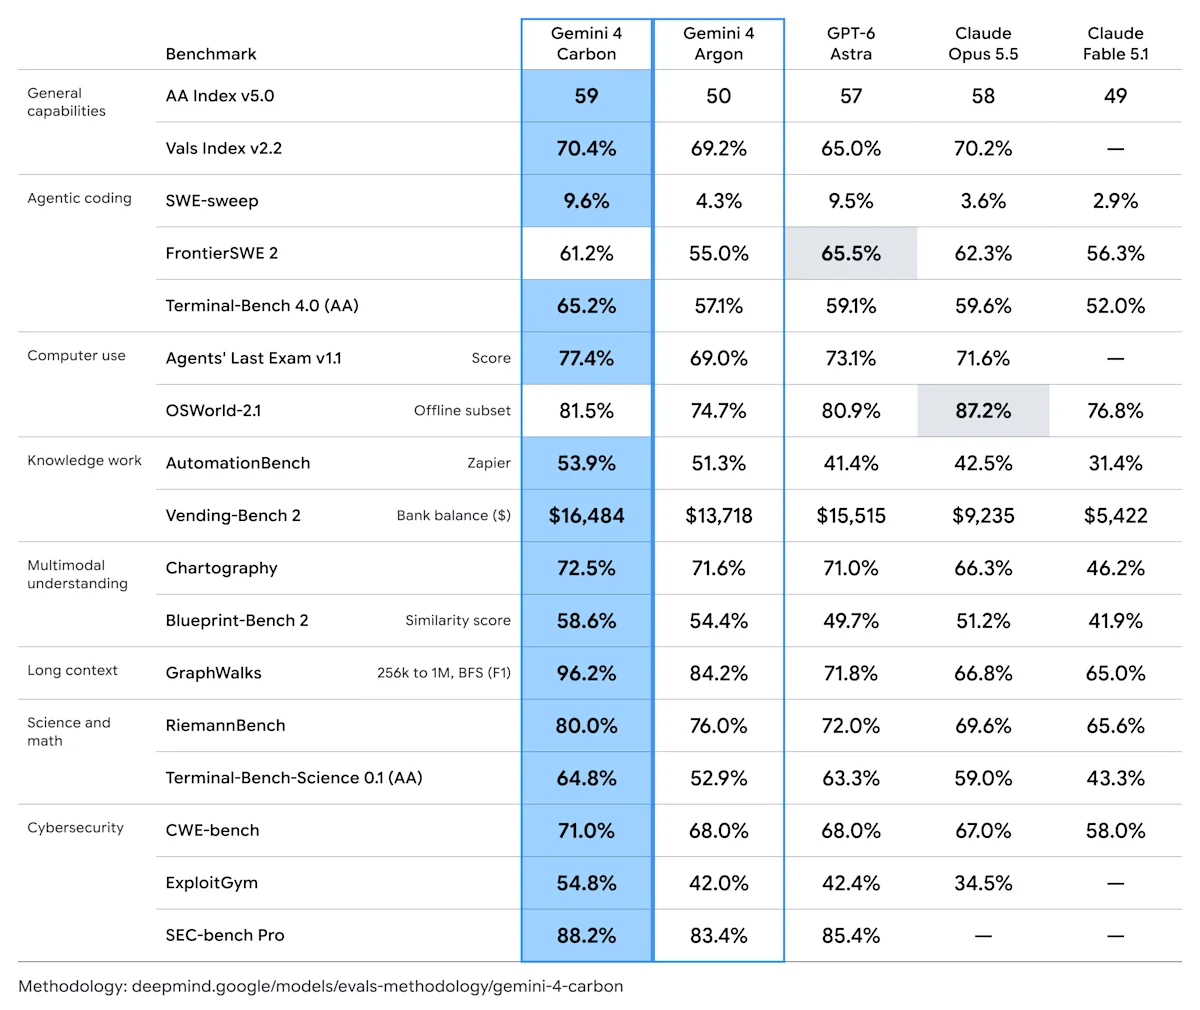
28 октября Google выложила анонс новой флагманской модели Gemini 4 Carbon. Независимая лаборатория Artificial Analysis поставила её на первое место в рейтинге Intelligence Index v5.0 с 59 баллами. Claude Opus 5.5 набрал 58, GPT-6 Astra - 57, прошлый флагман Google Gemini 4 Argon - 50. При этом купить доступ к новинке нельзя: Google пускает к модели только участников программы Fairwind, среди них защитники из сферы кибербезопасности.
Публичного API и даты широкого релиза нет. Google пишет, что откроет модель «как можно скорее», когда соберёт обратную связь и доработает ограничения.
Цифры на бенчмарках
В собственной таблице Google Carbon выигрывает 15 строк из 17. Сильнее всего он уходит вперёд там, где нужна длинная цепочка рассуждений и работа с кодом:
- GraphWalks, тест на контекст от 256 тысяч до 1 млн токенов: 96,2% против 71,8% у Astra и 66,8% у Opus.
- ExploitGym, поиск и проверка уязвимостей: 54,8% против 42,0% у Argon.
- Terminal-Bench-Science: 64,8% против 52,9% у Argon.
- Agents’ Last Exam: 77,4% против 69,0% у Argon.
- FrontierSWE 2, задачи для агентов в реальных репозиториях: 61,2% против 55,0% у Argon.
Carbon стоит 2 доллара за миллион входных токенов и 10 долларов за миллион выходных. Через какое-то время цены удвоятся до 4 и 20 долларов, но точной даты Google не назвала. У Argon переход на высокие цены назначен на 1 декабря 2026 года.
Где Carbon проигрывает
Лидерство не сплошное. На FrontierSWE 2 модель уступает Astra (65,5%) и Opus (62,3%). В OSWorld, тесте на управление компьютером, Opus набирает 87,2% против 81,5% у Carbon. В AA-Briefcase на профессиональных задачах Carbon вырос на 126 очков Elo, но остался позади Grok 4.7, Kimi K3.1 Pro и Muse Wonder.
Отдельного внимания заслуживает точность ответов. Artificial Analysis даёт Carbon лучший результат по общему индексу знаний AA-Omniscience (54 балла) и 58% верных ответов против 48% у Argon. При этом доля галлюцинаций выросла с 4% до 11%. Методика считает галлюцинацией неверный ответ среди всех неверных, частично верных и пропущенных, так что 11% не означает, что каждая девятая фраза выдумана. Но на фактах модель стала ошибаться чаще предшественника.
«Внутри наших команд Carbon работал по несколько дней подряд».
- Корай Кавукчуоглу, старший вице-президент Google DeepMind
Google заявляет, что модель вдвое реже выдаёт утверждения без опоры на источник, а число критичных предупреждений о поведении в коде упало почти на 80%. Это внутренние замеры компании, проверить их снаружи пока нечем: технический отчёт не опубликован, число параметров не названо.
Что это значит для бизнеса
Для компаний, которые уже строят процессы на модели Google, ситуация знакома по Argon: в сентябре доступ тоже открывали сначала узкому кругу партнёров, а через две недели выпустили в API и платные продукты. С Carbon повторяется тот же путь с разницей в акцентах. Основной упор - на кибербезопасность, длинную инженерную работу и стабильность агентов.
Практический вывод для тех, кто выбирает модель под внедрение искусственного интеллекта на Дальнем Востоке и в других регионах: держите в проекте возможность подмены модели. Переход на Carbon без публичного API невозможен, а накладные расходы на новую модель пока не измерены. Google не опубликовала данные о том, сколько токенов, повторов и времени уходит на одну успешную задачу, поэтому одинаковые цены за токен не означают одинаковую стоимость работы. Пока Argon остаётся единственной доступной моделью из этой линейки, тестировать и считать экономику агентов стоит на нём.