Gemini 4 Carbon обошёл Argon, но открыли её не для всех
Google выпустила Gemini 4 Carbon: первое место в индексе Artificial Analysis и доступ только специалистам по киберзащите. Что это значит для бизнеса.
Новости ИИ · Новости
Все новости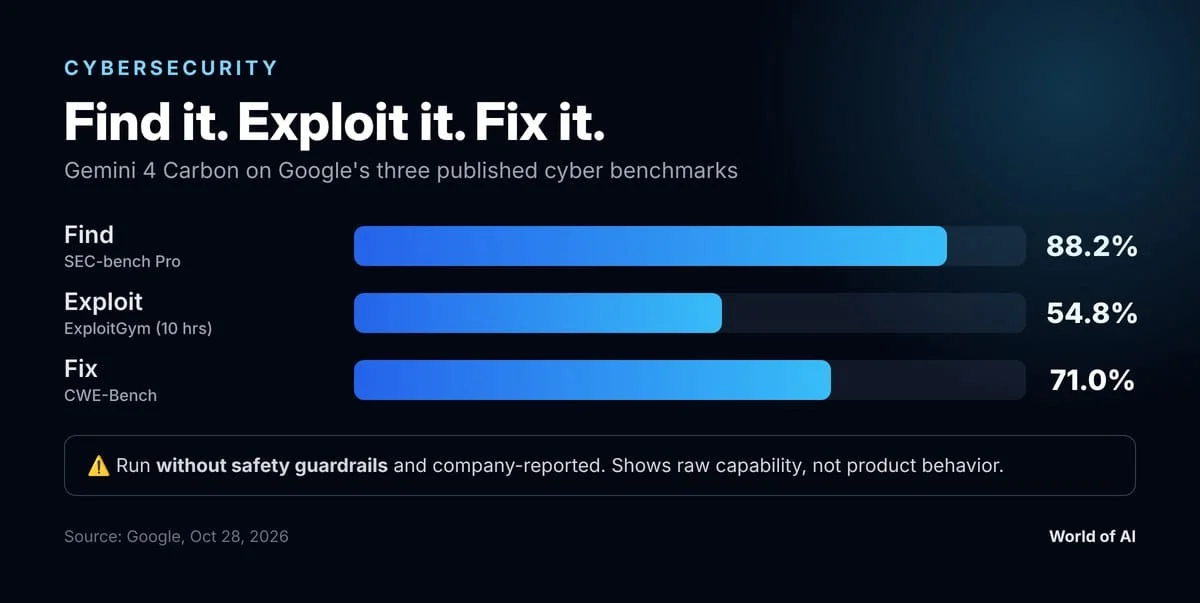
Восемь дней. Столько продержался Gemini 4 Argon на вершине Google, пока его место не занял Gemini 4 Carbon. Модель набрала 59 баллов в индексе интеллекта Artificial Analysis против 50 у предшественника. Но обычные разработчики её ещё не получили: Google отдала флагман сначала специалистам по киберзащите.
- 59 баллов в Artificial Analysis Intelligence Index, первое место. У Argon было 50.
- 88,2% в SEC-bench Pro на поиске уязвимостей.
- 54,8% в ExploitGym на превращении уязвимости в работающий эксплойт.
- 71,0% в CWE-Bench на исправлении ошибок в коде.
- 2 доллара за миллион входных токенов и 10 за миллион выходных, как у Argon.
Что именно выпустил Google
Carbon создавали под задачи, которые длятся днями. Внутренние команды Google давали модели работу на несколько суток, и она проходила тупики без вмешательства человека. Сами разработчики называют её сильнее Argon по разбору первопричин, исправлению ошибок в больших кодовых базах, научным рассуждениям и полному стеку веб-разработки.
В Text Arena модель поднялась на вершину с 1528 баллами. В WebDev Arena прибавила 89 Elo и заняла четвёртое место с показателем около 1769. В 15 из 16 собственных тестов Google Carbon тоже занял первое место.
Отдельно компания говорит о снижении выдумок. В её внутренних тестах Carbon выдаёт почти вдвое меньше утверждений без опоры на данные, чем Argon, и сообщает, если доказательств нет или действие заблокировали.
Главная история - кибербезопасность
Google впервые описывает модель вокруг полного цикла защиты: найти слабое место, доказать, что его можно использовать, закрыть причину. Опубликованные результаты совпадают с этой рамкой. Carbon держит первое место в трёх тестах, которые проверяют отдельно поиск уязвимости, её эксплуатацию и исправление.
Про Chrome команда Google заявила, что патчи безопасности от Carbon оказались «более чем в десять раз лучше», чем у флагманской модели неназванного конкурента. Проверить это со стороны нельзя. Конкурент остался без имени, кибертесты шли без защитных ограничений и с цифрами самой компании.
«Длинные задачи, где модель не бросает работу после первой ошибки и не придумывает результат, остаются главной проверкой для всех лабораторий».
- из разбора World of AI от 28 октября
Где Carbon отстаёт
Код по-прежнему за Claude. В Coding Agent Index Carbon получил 59 баллов против 62 у Claude Opus 5.5. В Agent Arena, где сравнили более 21 900 реальных сессий, Carbon занял второе место с приростом 16,2% против 21,1% у Opus 5.5. При этом у Carbon оказался самый высокий балл управляемости среди всех протестированных моделей.
Зато он дешевле в пересчёте на задачу. На одну задачу индекса интеллекта Carbon тратит в среднем 123 тысячи выходных токенов против 173 тысяч у Opus 5.5, а медианная задача в Agent Arena обходится в 1,80 доллара - на 72% меньше. Обратная сторона: он расходует в 2,3 раза больше токенов на рассуждения, чем Argon, а часть финансовых и юридических задач на Vals AI у него идёт более чем вдвое дольше.
Почему доступ дают по частям
Очередность объясняет, куда идут флагманские модели. Сначала избранные специалисты по защите систем, затем партнёры через программу Fairwind, потом разработчики и платные пользователи Gemini. Публичной даты для широкого доступа нет. Carbon также проходит добровольное предрелизное тестирование в правительстве США.
Цифры по безопасности поддерживают осторожность: ноль успешных попыток обмануть проверку на Terminal-Bench 4.0, ни одна тестовая атака не прошла косвенную инъекцию промпта в Gray Swan, а в живой разработке внутренних команд число критических оповещений о расхождении с целями упало почти на 80%.
Что это значит для бизнеса
Переезд планировать рано. Argon остаётся флагманом, который можно подключить сегодня, а у Carbon нет графика для разработчиков. Если компания закрывает корпоративные системы, стоит следить за открытием Fairwind: ранний доступ обещает проверить модель на собственном коде без публичного релиза.
Для команд во Владивостоке и на Дальнем Востоке практическая выгода видна в стоимости. Падение цены задачи на 72% при высоком балле интеллекта меняет экономику тех процессов, где разбор ошибок идёт долго. Посчитать эффект для своих задач помогает бесплатный AI-аудит: на нём видно, сколько сейчас стоит обработка одного обращения и что даст смена модели.